Confiança
Como funciona um sorteador online: semente e embaralhamento
Do número pseudoaleatório ao embaralhamento Fisher-Yates: como um sorteador escolhe o vencedor, onde nascem os vieses e o que a semente pública prova.
Um sorteador online funciona em quatro camadas: uma semente aleatória, criada no momento do sorteio; uma receita fixa que estica essa semente numa fila longa de números; uma conversão que leva cada número ao intervalo pedido sem favorecer ninguém; e um embaralhamento que põe a lista de participantes numa ordem ao acaso. O vencedor é só a leitura do resultado: o primeiro da lista embaralhada, ou os primeiros.
A seguir, cada camada com exemplos que você pode refazer, usando o algoritmo v1 do Sorteador, o mesmo do sorteio de números e do sorteio de nomes. Para saber se dá para confiar num resultado, veja o guia de sorteio online confiável; aqui o assunto é a mecânica.
Aleatório de verdade e pseudoaleatório
Um dado que rola na mesa é aleatório no sentido físico. Um computador, não: com as mesmas instruções e os mesmos dados, faz sempre a mesma coisa. Por isso quase todo número "aleatório" de um programa é pseudoaleatório. O NIST, o instituto de padrões dos Estados Unidos, define o gerador pseudoaleatório como um algoritmo determinístico que recebe uma sequência curta realmente aleatória, chamada semente, e devolve uma sequência muito mais longa que parece aleatória (glossário do NIST).
Nem todo gerador serve para sortear. A MDN avisa que o Math.random(), a função de acaso embutida no JavaScript, não gera números criptograficamente seguros (MDN). No mesmo glossário, o NIST descreve o gerador criptográfico pela propriedade de que a saída é imprevisível para quem não conhece a semente. Num sorteio, é isso que importa: ninguém deve adivinhar o próximo vencedor olhando os anteriores.
No Sorteador, a semente nasce no servidor, pela função crypto.getRandomValues do Node.js, que a documentação oficial descreve como geradora de valores "criptograficamente fortes" (Node.js). Uma nota, sem caráter normativo, do rascunho de trabalho (Working Draft) da especificação Web Cryptography Level 2, do W3C, recomenda que esses valores venham de geradores criptográficos consagrados, alimentados por entropia de alta qualidade, como a do sistema operacional (W3C). Sortear com Math.random() no navegador foi considerado no projeto e descartado: além de não ser criptográfico, rodaria no aparelho de quem sorteia.
A semente: por que o mesmo valor gera o mesmo sorteio
A semente do Sorteador tem 32 bytes, escritos como 64 caracteres hexadecimais. Nos exemplos deste artigo usamos a semente abaixo, gerada só para o texto, sem nenhum sorteio registrado no site:
1885f0e5eee30bd8d1cfc63404b9578e09ebd2ae4437acaaac7ac2f57f00f016
O v1 a transforma numa fila de números com o HMAC-SHA256. O HMAC, padronizado na RFC 2104, combina uma chave com uma função de resumo criptográfico, aqui o SHA-256, do padrão FIPS 180-4. A chave é a semente, e a mensagem é um contador de 8 bytes: 0 para o primeiro bloco, 1 para o segundo, e assim por diante. Cada bloco tem 32 bytes, lidos de 4 em 4 como inteiros de 32 bits, de 0 a 4.294.967.295. Com a nossa semente, o bloco 0 é:
4891523608707f8b7d9555840bc977e9bdb8b525ce3fee50159c1c91759b5403
Lido de 8 em 8 caracteres, ele começa com 1.217.483.318 (48915236), 141.590.411 (08707f8b) e 2.106.938.756 (7d955584). Guarde esses três números: eles aparecem em todos os exemplos a seguir.
Troque só o último caractere da semente, de 6 para 7, e o bloco 0 passa a começar com acb934b1ddff262f, sem semelhança com o anterior. É o esperado: no HMAC, a chave entra no cálculo do resumo, e o FIPS 180-4 diz que qualquer mudança na mensagem resulta, com probabilidade muito alta, num resumo diferente. Com a semente terminada em 7, a lista do exemplo adiante muda de ordem, e a moeda passa de cara para coroa.
Determinístico não quer dizer previsível. Com a semente na mão, qualquer computador refaz a mesma fila, hoje ou daqui a um ano. Sem ela, a fila não dá pistas. No Sorteador, a semente não existe antes do sorteio e, depois dele, fica pública no link do resultado.
O v1 não declara conformidade com normas de gerador certificado, como a NIST SP 800-90A: é uma construção curta, de peças padronizadas, publicada por inteiro na página do algoritmo. E não muda; qualquer alteração criaria um v2.
De bytes a um número de 1 a 100: o viés do resto da divisão e a rejeição
O gerador entrega números de 0 a 4.294.967.295, e o sorteio pede um de 1 a 100. O caminho óbvio é pegar o resto da divisão por 100 e somar 1. Ele quase funciona, e o "quase" tem nome: viés do resto da divisão. Para vê-lo a olho nu, imagine um gerador de um byte, de 0 a 255. São 256 valores para 100 resultados:
| Resto da divisão por 100 | Valores do byte que levam a ele | Chance de cada resto |
|---|---|---|
| 0 a 55 | 3 (o resto 7 vem de 7, 107 e 207) | 3/256 ≈ 1,17% |
| 56 a 99 | 2 (o resto 60 vem de 60 e 160) | 2/256 ≈ 0,78% |
Os 56 primeiros resultados saem com chance 50% maior que os outros 44 (cálculo próprio): o 10 seria favorecido em relação ao 90. Com 32 bits o efeito encolhe, mas não some: 4.294.967.296 dividido por 100 deixa resto 96, e os restos de 0 a 95 teriam um valor a mais que os de 96 a 99.
O v1 resolve com rejeição. Para sortear entre n opções, calcula o maior múltiplo de n que cabe em 32 bits: limite = ⌊2^32 ÷ n⌋ × n. Se o número lido for maior ou igual ao limite, ele é descartado e lê-se o próximo da fila. Só então se usa o resto da divisão. Abaixo do limite, cada resto aparece exatamente o mesmo número de vezes.
Com n = 100, o limite é 4.294.967.200. Só os 96 valores mais altos são descartados, o que acontece em cerca de 2 leituras a cada 100 milhões. Com a nossa semente, o primeiro número da fila, 1.217.483.318, fica abaixo do limite; o resto por 100 é 18, e o número sorteado é 1 + 18 = 19. Na cara ou coroa, nada é descartado, porque 2^32 já é múltiplo de 2.
É também por isso que, no sorteio de números, mínimo e máximo ficam entre −1 bilhão e 1 bilhão: o intervalo precisa caber abaixo de 2^32. Mesmo no pior caso dentro desse limite, gasta-se em média 1,5 leitura por número (cálculo próprio). O custo é ler alguns números a mais; o viés é zero.
Embaralhar uma lista: Fisher-Yates passo a passo com 4 nomes
Nos nomes, na roleta e nos times, o v1 embaralha a lista inteira e lê o começo. O método leva o nome de Ronald Fisher e Frank Yates, que o descreveram em 1938 para lápis, papel e tabela de números aleatórios. A versão para computador, que troca os itens de lugar, foi publicada por Richard Durstenfeld em 1964 (Communications of the ACM) e popularizada por Donald Knuth (histórico).
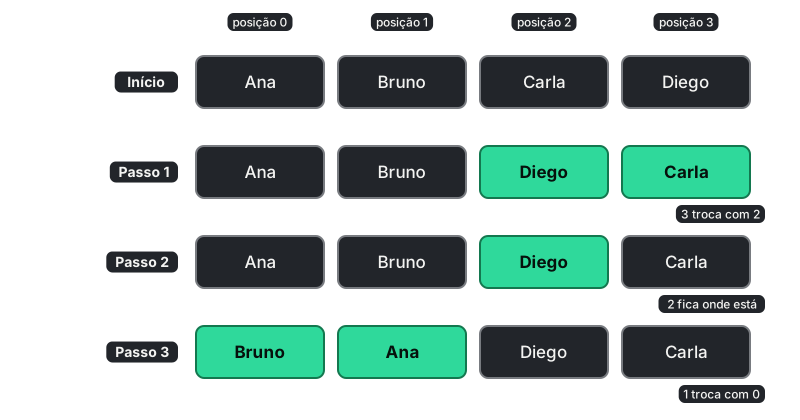
A regra cabe numa frase: do último item até o segundo, sorteie uma posição entre a primeira e a atual, inclusive, e troque os dois de lugar. Com a nossa semente e a lista Ana, Bruno, Carla, Diego, nas posições 0 a 3:
| Passo | Posição atual | Número da fila | Resto (por 4, 3 e 2) | Troca | Lista depois |
|---|---|---|---|---|---|
| 1 | 3 (Diego) | 1.217.483.318 | 2 | Diego com Carla | Ana, Bruno, Diego, Carla |
| 2 | 2 (Diego) | 141.590.411 | 2 | Diego com ele mesmo | Ana, Bruno, Diego, Carla |
| 3 | 1 (Bruno) | 2.106.938.756 | 0 | Bruno com Ana | Bruno, Ana, Diego, Carla |
A ordem final é Bruno, Ana, Diego, Carla. Dois detalhes fazem o método ser justo. O item pode ficar onde está, como Diego no passo 2; se isso fosse proibido, o último da lista nunca terminaria em último. E cada passo sorteia entre uma posição a menos: são 4 × 3 × 2 = 24 caminhos para as 24 ordens possíveis, um caminho por ordem, e cada ordem sai com chance 1/24, cerca de 4,17%.
Depois disso, cada ferramenta só lê a lista. Nos nomes, 1 vencedor dá Bruno, e 2 dão Bruno e Ana. Na roleta, vence Bruno; a animação só revela um vencedor registrado no servidor antes do giro. Nos times, a distribuição é em rodízio: com 2 times, Bruno e Diego no Time 1, Ana e Carla no Time 2. Os times nunca diferem em mais de uma pessoa.
Números sem repetição: o mesmo método, sem escrever a lista
Sortear 3 números de 1 a 100 sem repetição equivale a embaralhar os 100 números e ler os 3 primeiros. Para não escrever 100 cartões, o v1 faz um Fisher-Yates parcial: a partir da primeira posição, sorteia uma posição entre a atual e o fim, troca as duas e lê o valor que ficou na atual, anotando só as posições que mudaram. Com a mesma semente:
- Posição 0, entre 100 posições. O resto é 18. A posição 18 guarda o 19, que troca de lugar com o 1. Sai o 19.
- Posição 1, entre 99. O resto de 141.590.411 por 99 é 17, e 1 + 17 = 18. A posição 18 agora guarda o 1. Sai o 1.
- Posição 2, entre 98. O resto de 2.106.938.756 por 98 é 6, e 2 + 6 = 8. Sai o 9.
No passo 2, o sorteio caiu de novo na posição 18, mas o 19 já tinha saído dali: nada se repete, sem precisar sortear de novo. Com repetição permitida, cada número é só 1 mais o resto por 100 de um número da fila, e a mesma semente dá 19, 12 e 57.
O atalho errado e o tamanho do erro
Uma variante parece igual e não é: para cada posição, da primeira à última, trocar o item com qualquer posição da lista inteira. A Wikipédia a descreve entre os erros de implementação do Fisher-Yates. Com 3 nomes, são 3 × 3 × 3 = 27 caminhos para 6 ordens. Como 27 não se divide por 6, as ordens não podem ter a mesma chance (cálculo próprio):
| Ordem final (lista inicial: Ana, Bruno, Carla) | Caminhos | Chance no atalho | Chance no Fisher-Yates |
|---|---|---|---|
| Bruno, Carla, Ana | 5 de 27 | 18,5% | 16,7% |
| Bruno, Ana, Carla | 5 de 27 | 18,5% | 16,7% |
| Ana, Carla, Bruno | 5 de 27 | 18,5% | 16,7% |
| Carla, Ana, Bruno | 4 de 27 | 14,8% | 16,7% |
| Carla, Bruno, Ana | 4 de 27 | 14,8% | 16,7% |
| Ana, Bruno, Carla | 4 de 27 | 14,8% | 16,7% |
Num sorteio de 1 vencedor, Bruno, o segundo da lista, ganharia 37,0% das vezes (10 de 27), Ana 33,3% e Carla 29,6%. Com 4 nomes, Bruno venceria 29,3% das vezes, e Diego 21,1%, contra 25% para cada um (cálculo próprio, com 4^4 = 256 caminhos).
Por que isso importa. O erro não aparece num teste rápido: a lista sai "bem misturada" a olho nu. Só a contagem dos caminhos mostra o viés. Por isso faz diferença o sorteador publicar o método, e não só dizer que é aleatório.
Fora do computador, o erro tem parentes: no amigo secreto, o conserto "só quem se tirou sorteia de novo" distorce as chances, como mostra o guia de sorteio de amigo secreto.
Por que publicar a semente, e o que ela não prova
Semente, fila de números, rejeição e Fisher-Yates formam uma cadeia sem passo escondido: com a semente, a lista na ordem informada, os parâmetros e a versão, qualquer pessoa chega ao mesmo resultado. Essa conta prova que os vencedores publicados são exatamente os que o v1 produz com aqueles dados, e, como o resultado registrado não pode ser alterado, que nada foi trocado depois. Ela não prova três coisas:
- De onde veio a semente. Ela é gerada no servidor no momento do sorteio e aparece junto com o resultado; o v1 não divulga antes nenhum compromisso, como um resumo da semente. Nessa parte, você confia que o servidor a gera ao acaso.
- Que a lista era honesta. O sorteio é justo só entre quem estava na lista.
- Que aquela foi a primeira tentativa. Para isso, o link mostra quantos resultados com a mesma ferramenta, os mesmos parâmetros e a mesma lista foram registrados nos 10 minutos anteriores.
Como usar cada item na prática está no guia de sorteio online confiável e em como saber se um sorteio é verdadeiro.
Como cada ferramenta do Sorteador usa o mesmo fluxo
As cinco ferramentas seguem o mesmo fluxo, da semente de 32 bytes à fila de números. Muda só o último passo:
| Ferramenta | O que o v1 faz com a fila de números | Verificação no link |
|---|---|---|
| Sorteio de números | Com repetição, mínimo mais um inteiro do tamanho do intervalo; sem repetição, Fisher-Yates parcial | "Verificar agora", com semente e parâmetros |
| Sorteio de nomes | Fisher-Yates; vencem os primeiros | "Verificar agora", com lista completa |
| Sorteio de times | Fisher-Yates e rodízio | "Verificar agora", com lista completa |
| Roleta | Fisher-Yates; vence o primeiro | "Verificar agora", com lista completa |
| Cara ou coroa | Inteiro entre 0 e 1: 0 é cara, 1 é coroa | "Verificar agora", com a semente |
Duas consequências ajudam a entender o que você vê:
- A ordem da lista faz parte dos dados. Com a mesma semente, a lista Diego, Carla, Bruno, Ana dá Carla como vencedora, e acrescentar Elisa ao fim da lista original dá Ana. Por isso o v1 preserva a ordem informada, só tirando os espaços das pontas e as linhas vazias. Linhas repetidas contam como participantes separados, e a ferramenta avisa quantas são.
- "Sortear de novo sem os vencedores" é um sorteio novo. O botão (na roleta, "Girar de novo sem o vencedor") registra outro resultado, com semente nova e a lista que está na caixa no momento do clique, menos uma linha de cada vencedor do sorteio anterior.
Teste você mesmo com o código de referência
Quando quem sorteou marca "Exibir lista completa no link" antes de sortear, o link do resultado mostra o botão "Verificar agora", que refaz o sorteio no seu navegador com o mesmo código do servidor e diz se o resultado é igual ao publicado. Para não depender do botão, use o código de referência da página do algoritmo. Ele é escrito em TypeScript: rode-o com uma ferramenta que execute TypeScript ou, para colar no console do navegador, apague antes as anotações de tipo, como : string e : number.
Para saber se o código está rodando certo, chame a função de exemplo da página com a semente e a lista deste artigo:
await exemplo('1885f0e5eee30bd8d1cfc63404b9578e09ebd2ae4437acaaac7ac2f57f00f016', ['Ana', 'Bruno', 'Carla', 'Diego'])
A resposta deve ser: vencedores Bruno e Ana; três times, com Bruno e Carla no primeiro, Ana no segundo e Diego no terceiro; e lado cara. Rodamos o código da página com esses dados antes de publicar, nas duas formas, e ele devolveu exatamente isso. A função usa 3 times; com 2, como na seção sobre Fisher-Yates, sai Bruno e Diego contra Ana e Carla.
Para refazer um sorteio real, troque a semente e a lista pelas do link, na ordem em que ele as mostra, e ajuste a quantidade de vencedores ou de times.
Fontes
- NIST, Computer Security Resource Center. Glossário: pseudorandom number generator (definições da SP 800-22 Rev. 1a e da SP 800-90A Rev. 1). csrc.nist.gov
- MDN Web Docs. Math.random(). developer.mozilla.org
- Node.js. Web Crypto API: crypto.getRandomValues. nodejs.org
- W3C. Web Cryptography Level 2, Working Draft de 22 de abril de 2025, seção 10.1.1 (nota não normativa). w3.org
- H. Krawczyk, M. Bellare e R. Canetti. RFC 2104, HMAC: Keyed-Hashing for Message Authentication. Fevereiro de 1997. rfc-editor.org
- NIST. FIPS 180-4, Secure Hash Standard (SHS). Agosto de 2015. nvlpubs.nist.gov (PDF)
- R. Durstenfeld. Algorithm 235: Random permutation. Communications of the ACM, 7(7), p. 420, julho de 1964. doi.org
- Wikipédia. Fisher–Yates shuffle, com referências a Fisher e Yates (1938) e a Knuth. en.wikipedia.org
- Sorteador. Algoritmo de sorteio, versão v1. /algoritmo
Fontes externas consultadas em novembro de 2026. Cálculos próprios e exemplos conferidos em Python e com o código-fonte do Sorteador.
Perguntas frequentes
Como funciona o sorteador online?
Ele cria uma semente aleatória no momento do sorteio, a transforma numa fila de números com uma receita fixa, leva cada número ao intervalo pedido sem viés e, quando há lista, embaralha os participantes. No Sorteador, vencem os primeiros da lista embaralhada.
Como funciona o algoritmo do sorteador?
O algoritmo v1 do Sorteador usa uma semente de 32 bytes, o HMAC-SHA256 com um contador, a rejeição para eliminar o viés e o embaralhamento de Fisher-Yates. Ele está descrito, com código, na página do algoritmo, e não muda: uma alteração criaria um v2.
Gerador de números aleatórios é confiável?
Depende do gerador. O Math.random do JavaScript não é criptograficamente seguro. Para sortear, o ideal é um gerador criptográfico, cuja saída é imprevisível sem a semente, e um método publicado, que permita conferir o resultado.
O que é número pseudoaleatório?
É um número produzido por um algoritmo determinístico a partir de uma semente. A sequência parece aleatória, mas é sempre a mesma para a mesma semente, o que permite refazer um sorteio.
Dá para prever o vencedor conhecendo o algoritmo?
Não basta conhecer o algoritmo: o resultado depende da semente, que o servidor cria no momento do sorteio com um gerador criptográfico. O algoritmo serve para conferir, não para prever.
A animação da roleta decide quem ganha?
Não. O vencedor é registrado no servidor antes do giro, e a animação termina no setor dele.